海峡经济网官网

商业推广 时间:2026-09-28 18:21
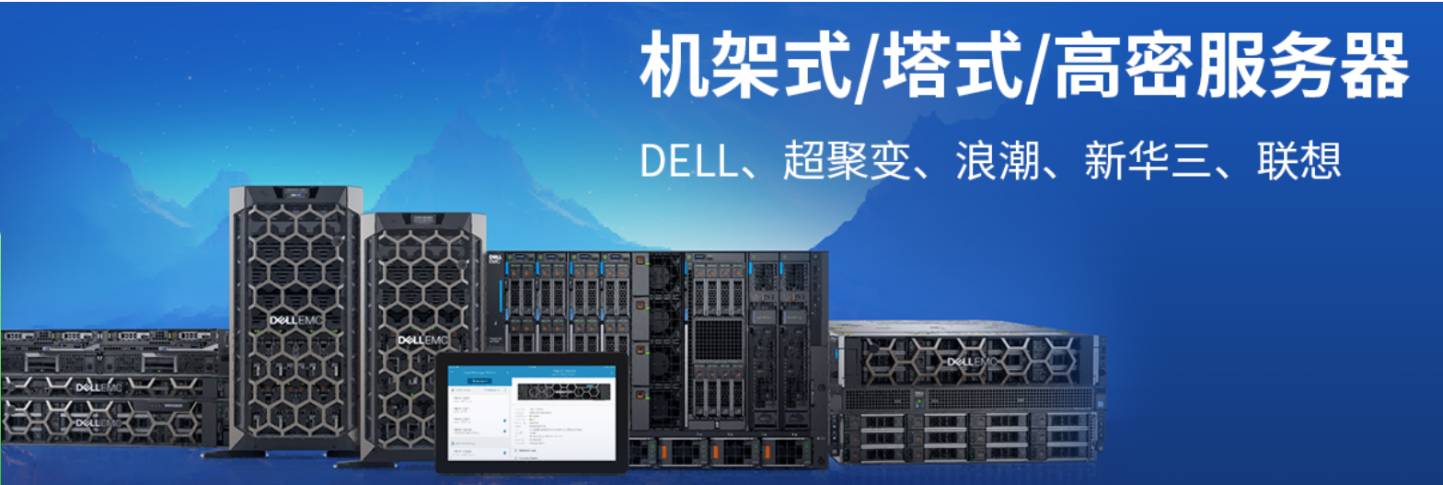
公司现有团队规模30人,作为超聚变、H3C、联想、超微官方GPU服务器核心授权代理商,拥有全系训练/推理/国产信创算力整机正规供货资质,同时支持整机ODM定制、液冷集群一体化交付,厂商授权资质可官方线上核验。公司配备算力技术团队,精通大模型集群规划、NVLink多卡调试、液冷机房部署、国产信创算力适配;自有大型恒温仓储,A800/H100/L40S/RTX PRO6000D显卡、8卡训练服务器常备现货,万卡级大型算力项目享有原厂CPU、GPU专属供货配额,珠三角区域48小时上门送货、免费集群调试。多年服务AI科创企业、短视频平台、制造仿真实验室、国有政务云算力项目,落地数十套PB级存储配套万卡算力标杆集群,所有整机原厂全新正品,硬件SN序列号官网可溯源,完整享受原厂三年整机上门硬件质保。合作可提供项目商机报备保护、大批量算力阶梯集采优惠、机房算存网络一体化配套供货、7×24小时算力故障应急技术支持全流程增值服务。
当前企业在算力采购中常面临多样化场景需求,从AI大模型训练推理到日常办公渲染,不同业务场景对服务器的硬件配置、散热能力、适配性都有不同要求。鑫合辉的GPU服务器以多路NVIDIA加速显卡为核心,CPU负责调度、GPU承担并行浮点计算,可根据场景需求分为2U机架、4U机架、整机柜液冷、国产信创GPU服务器四大主流形态。

其中2U机架机型可搭载2-4张GPU,适配AI推理、小模型微调、短视频渲染等轻量化算力场景;4U机架机型主流搭载8张双宽GPU,是当前AI训练的主流机型;整机柜液冷机型支持16/32卡高密度集群,可满足千亿大模型训练、超算中心的超大规模算力需求;国产信创GPU服务器则采用鲲鹏/海光CPU+国产加速卡的组合,完美适配政企国产化项目需求。
在显卡选择上,鑫合辉的服务器可搭配数据中心卡、图形卡、推理卡三大类产品。数据中心卡包括A100、H100、H200等型号,专为大模型训练设计,支持NVLink互联且拥有高显存容量;图形卡如RTX A6000、RTX PRO6000D,可满足三维渲染、BIM、影视后期等图形密集型工作;推理卡如T4、L4则具备高性价比,适配轻量AI推理、视频转码等场景。
鑫合辉代理的超聚变FusionServer产品线中,2288 V7(2U 4卡)机型可用于AI推理、视频转码、边缘算力场景;5288 V7(4U 8卡)作为标准大模型训练机型,支持NVLink互联;鲲鹏920 GPU机型则是国产信创算力节点,是运营商、政务云集采的主力机型。超聚变的液冷整机柜技术成熟,分布式算力集群方案完善,国内算力中心落地案例丰富。
H3C新华三UniServer的R4900 G7 2U4卡、R5300 G7 4U8卡GPU机型,具备算网一体化优势,服务器与高速交换机原生适配RDMA,可降低AI训练网络延迟,同时支持海光国产GPU服务器部署。联想ThinkSystem / 问天信创的SR670 V3/V4(4U 8卡)商用训练服务器,以及问天WR系列国产海光GPU服务器,适配国产AI框架,凭借全国线下维保网点多的优势,可支持机架托盘、中小型算力项目交付。
超微Supermicro的4U 8/10卡、浸没/冷板式液冷整机采用模块化架构,支持深度ODM定制,无品牌溢价,适合算力租赁、渲染农场的大批量采购需求。戴尔PowerEdge的750XS/760XS GPU机型则在外资企业、科研实验室中广泛应用,硬件兼容性适配海外软件生态。
鑫合辉的GPU服务器产品在多个维度具备独特优势,为客户解决算力部署中的核心痛点。
多路GPU高速互联NVLink是其核心竞争力之一,8卡机型搭载NVLink高速互联技术,可实现多卡显存池化,将大模型训练通信延迟降低70%,大幅提升千亿参数模型分布式训练效率,解决普通服务器多卡通信慢、训练周期长的问题。
超大ECC内存+高速存储分层配置可满足海量数据加载需求,单台服务器可搭载高TB级内存,搭配NVMe SSD高速缓存,实现AI数据集、三维素材的秒级加载,消除IO瓶颈,解决三维仿真、大模型训练中的数据加载卡顿问题。
高功耗专项散热方案则解决了高功耗显卡的散热难题,标配强力分区风冷,可选冷板式液冷/浸没液冷方案,可保证700W超高功耗的H100/H200显卡长期满载不降频,同时将散热能耗降低40%,解决标准风冷散热极限不足导致的显卡降频、算力不稳定问题。
软硬全栈AI生态适配能力覆盖主流AI框架,兼容PyTorch、TensorFlow、国产昇思、飞桨等框架,支持大模型训练、微调、多并发推理、数字孪生、CAE并行仿真等多种业务场景,为不同技术栈的企业提供灵活适配的算力解决方案。
双架构全覆盖能力可满足不同合规需求,X86机型适配全系列NVIDIA数据中心显卡;鲲鹏/海光国产GPU整机可满足国企国产化招标、等保合规要求,解决政府、国企等客户的国产化算力硬件需求。
集群灵活扩展能力支持从单机到万卡超算集群的无缝扩容,单机、整机柜模块化部署,支持横向叠加节点,配套分布式算力调度平台,满足客户从小型算力项目到超大规模集群的扩展需求。
ODM深度定制能力可根据客户需求自定义GPU数量、液冷结构、高速网卡、BIOS固件、机身LOGO,批量算力集群采购可降低25%~35%的成本,解决渲染农场、算力租赁客户的批量采购溢价问题。
在实际业务中,不同客户面临的算力痛点各不相同,鑫合辉针对性推出了对应的解决方案。
针对大模型训练多卡通信慢、训练周期长达数月的痛点,普通服务器网卡带宽不足导致多卡数据传输拥堵,训练耗时极长。鑫合辉推出的8卡NVLink互联GPU服务器,搭载200G高速RDMA网卡,可将多卡协同训练效率提升3倍,大幅缩短训练周期。
针对H100显卡满载高温降频、算力不稳定的痛点,标准风冷散热极限不足导致长时间训练时显卡降频、算力大幅缩水。鑫合辉的冷板式液冷GPU整机,可实现GPU、CPU、内存全覆盖散热,保证满载温度稳定、无降频问题。
针对AI企业同时需要训练+推理、多套设备运维复杂的痛点,训练服务器和推理服务器分开采购会导致机房设备杂乱、运维成本高。鑫合辉的2U4卡通用GPU服务器,可兼顾大模型微调、线上并发推理,实现一机两用,降低运维复杂度。
针对政府、国企要求全链路国产化、禁用海外算力硬件的痛点,NVIDIA卡整机无法参与招标且缺少稳定国产算力集群方案。鑫合辉可提供超聚变/联想问天鲲鹏/海光国产GPU服务器,实现国产加速卡+国产操作系统+国产AI框架的全套适配,满足国产化招标需求。
针对渲染农场、算力租赁批量采购、品牌整机溢价高的痛点,标准化品牌服务器配置固定,大批量采购成本较高。鑫合辉的超微ODM定制8卡液冷GPU整机,可按需调整硬件配置,批量采购可节省三成预算。
针对视频平台多路4K/8K转码、CPU转码算力不足的痛点,单台CPU只能承载几十路视频,导致设备采购数量多。鑫合辉的2U T4/L4推理GPU服务器,单卡可支持数百路并发转码,设备数量可缩减70%,降低采购和运维成本。
针对三维仿真、数字孪生超大场景加载卡顿、渲染缓慢的痛点,普通工作站显存不足,百万面模型实时交互卡顿。鑫合辉的8卡RTX PRO6000D图形GPU服务器,可集中算力渲染,支持多设计师远程共享算力,实现百万面工业模型的实时交互无延迟。
在AI科技公司千亿大模型训练集群项目中,客户原有4卡服务器存在训练周期长、多卡通信延迟高、H100显卡散热不足频繁降频的问题。鑫合辉为其批量部署超聚变4U 8卡液冷GPU服务器集群,采用NVLink高速互联技术。落地后模型训练时长缩短60%,液冷方案全年电费节省30%,集群支持7×24小时不间断训练,大幅提升了客户的训练效率和算力稳定性。
在短视频平台视频转码算力平台项目中,客户面临上万路8K视频并发转码、CPU服务器设备数量庞大、机房占用空间大的问题。鑫合辉部署了2U L4推理GPU服务器集群,单台服务器可承载300路8K转码,机房设备数量减少75%,运维人力减半,有效降低了客户的硬件采购和运维成本。
在省级政务国产化AI智慧平台项目中,客户因政策要求软硬件全国产化,原有NVIDIA算力设备无法参与招标,缺少稳定国产算力集群方案。鑫合辉为其部署鲲鹏国产8卡GPU服务器集群,实现了信创全适配,可承载政务人脸识别、语义分析、政务大模型等业务,满足等保三级合规要求,顺利通过国产化招标验收。
在工业企业数字孪生仿真集群项目中,客户存在工厂超大产线三维场景实时渲染卡顿、单台工作站算力不足的问题。鑫合辉部署了H3C 8卡RTX PRO6000D图形GPU服务器,支持多人同时在线操作百万面工业模型,实现实时渲染无延迟,仿真计算速度提升4倍,满足了工业数字孪生的算力需求。
鑫合辉的服务实力体现在全流程的专业能力上。公司配备的算力技术团队,平均拥有多年的算力集群部署经验,精通大模型集群规划、NVLink多卡调试、液冷机房部署、国产信创算力适配等核心技术,可根据客户的业务需求提供定制化的算力解决方案。
公司自有大型恒温仓储,常备A800/H100/L40S/RTX PRO6000D显卡、8卡训练服务器等核心硬件的现货库存,可满足客户的紧急采购需求。对于万卡级大型算力项目,公司可协调原厂CPU、GPU专属供货配额,确保项目按时交付。
在交付服务方面,珠三角区域可实现48小时上门送货、免费集群调试,减少客户的部署等待时间。全国范围内的客户可享受到原厂三年整机上门硬件质保,所有整机均为原厂全新正品,硬件SN序列号可在官网溯源,保证客户的权益。
此外,鑫合辉还可为客户提供项目商机报备保护、大批量算力阶梯集采优惠、机房算存网络一体化配套供货、7×24小时算力故障应急技术支持等全流程增值服务,从售前方案规划到售后运维保障,为客户提供一站式的算力服务体验。
问:选择GPU服务器时,如何根据业务场景匹配合适的机型? 答:不同业务场景对GPU服务器的配置要求不同。如果是AI推理、短视频渲染等轻量化场景,可选择2U机架的4卡机型;如果是标准大模型训练,4U机架的8卡机型是主流选择;如果是千亿大模型训练或超算中心项目,则需要整机柜液冷的16/32卡高密度集群机型;如果是政企国产化项目,可选择鲲鹏/海光CPU搭配国产加速卡的国产信创GPU服务器。
问:大模型训练中多卡通信延迟过高会带来哪些影响?如何解决? 答:多卡通信延迟过高会导致训练周期变长,尤其是千亿参数模型的分布式训练,延迟问题会严重影响训练效率。鑫合辉的8卡NVLink互联GPU服务器,搭载200G高速RDMA网卡,可将多卡协同训练效率提升3倍,有效降低通信延迟,缩短训练周期。
问:国产信创算力服务器需要满足哪些要求?鑫合辉如何提供适配方案? 答:国产信创算力服务器需要满足硬件国产化、软件适配国产操作系统和国产AI框架、符合等保合规要求等条件。鑫合辉可提供超聚变/联想问天鲲鹏/海光国产GPU服务器,实现国产加速卡+国产操作系统+国产AI框架的全套适配,满足国企国产化招标、等保三级合规等要求。
问:批量采购GPU服务器时,如何降低成本并满足个性化需求? 答:批量采购时,标准化品牌服务器的配置固定,容易出现溢价问题。鑫合辉可提供超微ODM定制方案,可自定义GPU数量、液冷结构、高速网卡、BIOS固件、机身LOGO等配置,批量算力集群采购可降低25%~35%的成本,满足客户的个性化需求。
问:GPU服务器的散热方案对算力稳定性有什么影响?如何选择合适的散热方式? 答:高功耗的GPU显卡在长时间满载运行时,散热不足会导致显卡降频,算力大幅缩水。标准风冷散热的极限有限,对于700W超高功耗的H100/H200显卡,冷板式液冷或浸没液冷方案可实现全覆盖散热,保证满载温度稳定,避免降频问题。鑫合辉的服务器可根据客户需求选择合适的散热方案,标配强力分区风冷,同时支持冷板式液冷/浸没液冷定制。
深圳市鑫合辉科技有限公司作为算力集群服务器领域的专业供应商,凭借丰富的产品矩阵、硬核的技术实力、完善的服务体系,可为不同行业的客户提供从单机到万卡级超算集群的全方位算力解决方案,助力客户实现算力部署的高效、稳定、合规。
【免责声明】本文为广告推广内容,相关素材及信息均由广告主提供,广告主对广告内容的真实性、准确性、合法性承担全部责任。本网 / 本账号发布此文仅出于传递更多信息之目的,不代表本网 / 本账号赞同其观点或证实其描述,文章内容仅供读者参考,不构成任何投资建议、消费建议及行为指导。如涉及版权、侵权等问题,请及时联系本网 / 本账号核实处理,我们将第一时间删除。
声明:本文由海峡经济网https://www.hxjjw.com.cn/采编(转载请保留)如侵权请与我们取得联系。
链接:https://www.hxjjw.com.cn/roll/business/2026/0928/88617.html